×
Foxycom
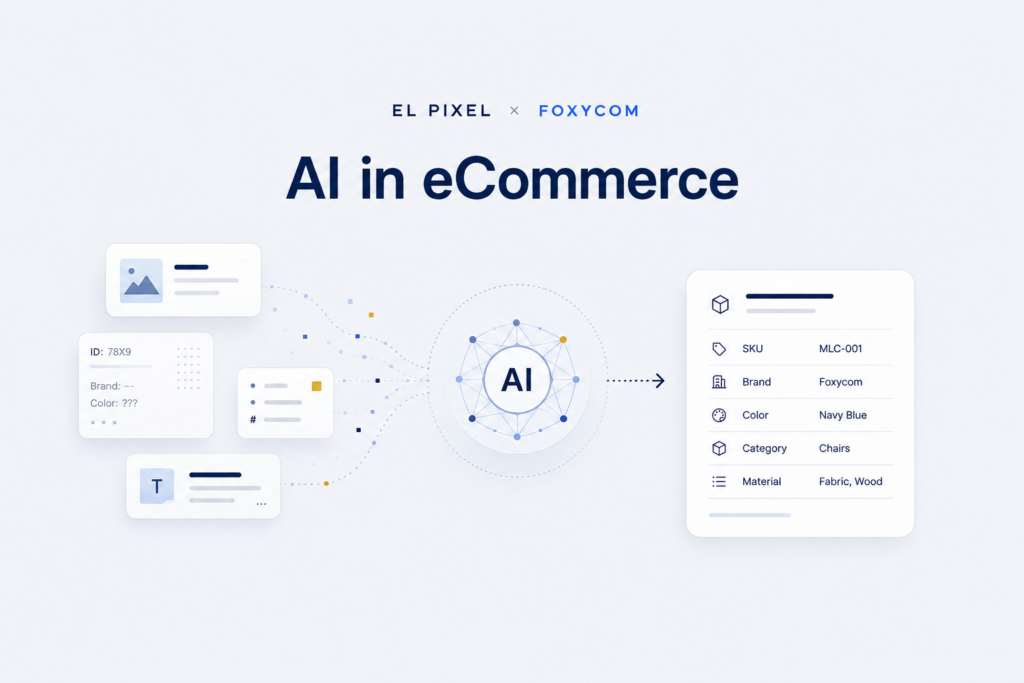
AI może wygenerować opis produktu w kilka sekund.
Trudniej zadbać o to, aby model nie wymyślił brakującej cechy, nie przypisał błędnej kategorii i zwrócił dane w formacie, z którym katalog rzeczywiście może pracować.
Dane produktowe rzadko trafiają do systemu w formie gotowej do publikacji. Mogą pochodzić z feedów dostawców, systemów wewnętrznych, źródeł internetowych i istniejących katalogów. Ta sama właściwość może mieć różne nazwy, występować w różnych formatach albo być ukryta w zwykłym opisie tekstowym.
Modele językowe dobrze sprawdzają się w takich zadaniach, ponieważ potrafią interpretować różne sformułowania bez tworzenia osobnej reguły dla każdego przypadku.
Mimo to wynik modelu nadal wymaga weryfikacji.
Gdzie AI rzeczywiście przynosi wartość
Logika oparta na regułach dobrze radzi sobie z przewidywalnymi operacjami. Może sprawdzić format daty, przekształcić wartość, zweryfikować obecność wymaganego pola albo porównać dane z kontrolowanym słownikiem.
Problem staje się trudniejszy, gdy znaczenie informacji zależy od kontekstu.
Jeden dostawca może przekazywać materiał produktu jako osobny atrybut. Inny wspomina o nim wyłącznie w opisie. Trzeci używa skrótu albo własnego systemu nazewnictwa.
Każdy z tych przypadków można obsłużyć kolejną regułą. Jednak wraz ze wzrostem liczby źródeł i formatów utrzymanie takiego systemu staje się coraz trudniejsze.
AI może pomóc w:
- wyodrębnianiu atrybutów z nieustrukturyzowanego tekstu;
- mapowaniu różnych sformułowań do wspólnego modelu wewnętrznego;
- przekształcaniu opisów w określony zestaw pól;
- sugerowaniu lub rankingowaniu kategorii z istniejącej taksonomii;
- przygotowywaniu i dostosowywaniu treści produktowych.
Takie zastosowania nie są potrzebne w każdym sklepie internetowym. Jeżeli dane produktowe już trafiają do systemu w stabilnej strukturze, dodanie modelu językowego może niewiele wnieść. AI staje się najbardziej użyteczne tam, gdzie te same informacje występują w wielu formach, a utrzymywanie kompletnego zestawu deterministycznych reguł przestaje być praktyczne.
Samo zaproponowanie kategorii lub wartości atrybutu również nie wystarcza. Wynik trzeba jeszcze zmapować do rzeczywistego modelu katalogu platformy commerce.
Magento
Kategoria lub atrybut zaproponowany przez AI staje się użyteczny dopiero wtedy, gdy można go zmapować do rzeczywistego modelu katalogu Magento. Sugerowana kategoria powinna odpowiadać istniejącemu category ID, a atrybuty — istniejącym attribute codes w attribute set przypisanym do produktu. Typ produktu również musi być jednoznacznie określony i prawidłowy dla katalogu, na przykład simple, configurable, virtual, downloadable, bundle lub grouped.
W przypadku atrybutów select i multiselect wartości powinny być dopasowywane do istniejących opcji Magento. Model nie powinien samodzielnie tworzyć nowych elementów taksonomii. Jeśli odpowiednia opcja nie istnieje, jej utworzenie powinno być kontrolowaną decyzją na poziomie katalogu, a nie decyzją AI. W praktyce warstwa AI może proponować kategorie i wartości atrybutów, natomiast deterministyczna warstwa mapowania przekształca je w identyfikatory Magento przed zapisaniem danych.
Nawet po prawidłowym mapowaniu system nadal musi sprawdzić, czy model poprawnie zinterpretował dane źródłowe.
Wynik modelu powinien pozostać etapem pośrednim. To system powinien zdecydować, czy dane nadają się do dalszego wykorzystania.
Załóżmy, że model otrzymuje opis produktu i zwraca w uporządkowanej formie materiał, kolor oraz rodzaj zapięcia. Samo sprawdzenie formatu odpowiedzi nie wystarcza.
System musi również sprawdzić, czy:
- takie pola istnieją w wewnętrznym modelu danych;
- wartości należą do dozwolonych słowników;
- atrybuty są prawidłowe dla danego typu produktu;
- dane źródłowe rzeczywiście potwierdzają wniosek modelu.
Ten ostatni punkt jest szczególnie ważny. Leather może być prawidłową wartością w słowniku materiałów, ale sam fakt jej istnienia w słowniku nie dowodzi, że konkretny produkt został wykonany ze skóry.
W przypadku atrybutów opisujących fakty model może zwracać proponowaną wartość razem z dokładnym fragmentem źródła albo wskazaniem pola, z którego została ona wyodrębniona. Nie potwierdza to automatycznie poprawności interpretacji, ale pozwala prześledzić, na jakich danych opiera się wynik.
Jeśli źródło nie zawiera odpowiedniej informacji, jest niejednoznaczne lub pozostaje w sprzeczności z innymi danymi, bezpieczniejszym rozwiązaniem może być pozostawienie pola pustego albo skierowanie go do dodatkowej weryfikacji.
Dlaczego wyniku modelu nie należy od razu wysyłać do katalogu
Model językowy może zwrócić przekonującą i dobrze ustrukturyzowaną odpowiedź nawet wtedy, gdy dane wejściowe zawierają zbyt mało informacji.
Model może na przykład:
- uzupełnić cechę, której w źródle w ogóle nie było;
- zwrócić wiarygodnie brzmiącą, ale błędną wartość;
- wybrać niewłaściwą kategorię;
- poprawnie zrozumieć tekst, ale zapisać wynik w niewłaściwym polu;
- naruszyć strukturę oczekiwaną przez system docelowy;
- przetwarzać podobne opisy w różny sposób.
Błędny format danych zazwyczaj łatwo wykryć i automatycznie odrzucić. Wiarygodnie wyglądające błędy są bardziej niebezpieczne, ponieważ mogą przejść dalej w procesie właśnie dlatego, że wydają się logiczne.
Konsekwencje błędu zależą również od rodzaju danych. Niezręczne zdanie w roboczym opisie można poprawić. Nieprawidłowy parametr kompatybilności albo obowiązkowa specyfikacja techniczna mogą już wpływać na filtrowanie, wybór produktu i decyzję klienta.
Cenę, SKU i stany magazynowe w większości przypadków lepiej pobierać z systemów będących właścicielem tych danych, zamiast próbować wywnioskować je z nieustrukturyzowanego tekstu za pomocą modelu generatywnego.
Jakość promptu ma znaczenie, ale główną kontrolę zapewnia proces otaczający model.
Jak włączyć AI do kontrolowanego procesu
W uproszczeniu proces wygląda następująco:
źródłowe
kontekstu
produktu
commerce
Przed wysłaniem zapytania do modelu system powinien określić:
- jakie dane otrzymuje model;
- jaką operację powinien wykonać;
- które pola może zmieniać;
- jakie wartości są dozwolone;
- w jakim formacie ma zostać zwrócona odpowiedź;
- co zrobić w przypadku braku informacji.
Model nie musi otrzymywać całego rekordu produktu przy każdym zadaniu. Im precyzyjniej dobrany jest kontekst, tym łatwiej ocenić wynik i tym mniej zbędnych informacji model musi interpretować.
Osobne operacje są również łatwiejsze do testowania i debugowania. Jedno zapytanie, które jednocześnie wyodrębnia atrybuty, wykrywa duplikaty, wybiera kategorię i tworzy treść marketingową, jest znacznie trudniejsze do kontrolowania.
Ustrukturyzowana odpowiedź pozwala programowo sprawdzić wymagane pola, typy danych i format.
Zgodność ze schematem nie mówi jednak nic o faktycznej poprawności treści.
Dlatego walidację najlepiej przeprowadzać na kilku poziomach:
Nieudana walidacja powinna prowadzić do wcześniej zdefiniowanego scenariusza. System może zachować wartość źródłową, zastosować regułę deterministyczną, ponowić zapytanie z innym kontekstem albo skierować rekord do ręcznej weryfikacji.
Po przejściu walidacji dane mogą zostać przekazane do platformy commerce. Kolejną kwestią jest sposób integracji oraz uwzględnienie struktury katalogu.
Magento
Przy masowych aktualizacjach katalogu realizowanych przez API zwykle korzystamy z asynchronicznych lub Bulk REST API Magento tam, gdzie pasują one do danej integracji. Commerce umieszcza poszczególne operacje w kolejce i pozwala niezależnie śledzić ich statusy. Ułatwia to monitorowanie dużych zadań oraz izolowanie i ponowne przetwarzanie rekordów zakończonych błędem.
Synchroniczny REST lepiej sprawdza się przy mniejszych aktualizacjach, w których istotne są niewielkie opóźnienia. Regularne feedy produktowe, w zależności od wielkości katalogu, częstotliwości aktualizacji i systemu źródłowego, mogą być obsługiwane przez import pipeline lub middleware.
Configurable products wymagają dodatkowej orkiestracji, ponieważ produkt nadrzędny, produkty podrzędne, configurable attributes i product links są zależnymi elementami tej samej struktury. Integracja powinna uwzględniać te zależności, zamiast traktować każde wywołanie API jako niezależną aktualizację.
Import powinien być również idempotentny: ponowne przetworzenie tego samego rekordu źródłowego powinno zaktualizować właściwy SKU i jego relacje, zamiast tworzyć sprzeczny stan katalogu.
Sposób przekazywania danych zależy od konkretnej architektury, ale rola modelu pozostaje taka sama. Model odpowiada tylko za jeden etap procesu i nie decyduje o końcowym stanie katalogu.
Workflow AI trzeba przetestować przed uruchomieniem
Walidacja podczas działania systemu chroni pojedyncze rekordy, ale nie odpowiada na inne pytanie: czy cały scenariusz wykorzystania AI działa wystarczająco dobrze, aby trafić na produkcję.
Kilka udanych przykładów to za mało.
Proces należy przetestować na reprezentatywnym zbiorze rzeczywistych danych produktowych, dla których z góry znane są poprawne wyniki. Taka ewaluacja pozwala sprawdzić:
- jak często model zwraca poprawną wartość;
- ile istniejących atrybutów pomija;
- jak często dodaje wartości niepotwierdzone w źródle;
- dla których kategorii produktów jakość wyników spada;
- jakie formaty źródeł i sformułowania najczęściej prowadzą do błędów.
Przy wyodrębnianiu atrybutów trzeba znaleźć odpowiednią równowagę. Zbyt ostrożny model może pozostawiać zbyt wiele pustych pól. Bardziej agresywna konfiguracja może zwiększyć liczbę wartości niepotwierdzonych przez źródło.
Akceptowalny poziom automatyzacji zależy od zadania. Roboczy opis produktu może pozwalać na większą swobodę niż dane dotyczące kompatybilności lub obowiązkowych parametrów technicznych.
Ewaluację warto powtarzać po istotnych zmianach modelu, promptu, struktury danych wejściowych lub reguł biznesowych. Dobry wynik dla jednej konfiguracji nie gwarantuje takiego samego zachowania po aktualizacji.
Takie testy pomagają określić, czy wynik AI nadaje się do wykorzystania w procesie produkcyjnym. Później pozostają już pytania dotyczące samej architektury commerce: jakie dane powinno otrzymywać Magento, który system jest właścicielem poszczególnych danych i gdzie powinna znajdować się logika transformacji.
W tym miejscu zaczyna się obszar ekspercki Foxycom.
Co dzieje się po AI: perspektywa Magento według Foxycom
Jakie dane powinno otrzymywać Magento?
W idealnym scenariuszu interpretacja danych powinna być zakończona jeszcze przed ich przekazaniem do Magento. Magento powinno otrzymywać rekord produktu zapisany we własnym modelu katalogu: canonical SKU, jednoznacznie określone product type i attribute set, przypisania kategorii, attribute codes, rozpoznane wartości dla atrybutów select i multiselect oraz prawidłowy store-view context dla pól o odpowiednim scope.
W przypadku configurable products wcześniej powinny być również znane SKU produktów podrzędnych, configurable attributes oraz wartości ich opcji. Typowe błędy na tym etapie są zazwyczaj błędami mapowania, a nie AI: brakująca option value, atrybut spoza przypisanego attribute set, nieprawidłowy category ID, niepełne identyfikatory produktu albo wartość store-scoped zapisana w niewłaściwym kontekście.
Magento powinno walidować i zapisywać rekord produktu. Nie powinno natomiast samodzielnie ustalać, co miały oznaczać przychodzące dane.
Gdzie powinna przebiegać granica między Magento a warstwą zewnętrzną?
Wyznaczamy tę granicę tak, aby interpretacja, wzbogacanie i normalizacja danych odbywały się poza Magento, natomiast samo Magento egzekwowało reguły katalogu właściwe dla platformy commerce podczas zapisywania danych.
Warstwa zewnętrzna może wyodrębniać atrybuty, normalizować terminologię, mapować kategorie i wartości atrybutów, deduplikować rekordy źródłowe oraz przygotowywać canonical product payload. Magento następnie stosuje reguły platformy dotyczące produktów, kategorii, relacji, scope oraz integralności katalogu.
Równie ważne jest jednoznaczne określenie właściciela każdego pola. Zewnętrzny content pipeline może odpowiadać za opisy wzbogacone przez AI, podczas gdy ceny i stany magazynowe mogą należeć do ERP albo Magento — zależnie od szerszej architektury. Dla każdego pola powinno być jasno określone source of truth oraz kierunek aktualizacji.
Ta sama zasada dotyczy mapping logic. Mapowania kategorii, atrybutów i wartości powinny być przechowywane w jednym miejscu. Jeśli te same reguły zostaną niezależnie zaimplementowane w middleware oraz Magento import scripts, z czasem zaczną się rozchodzić. W efekcie mogą pojawić się sprzeczne aktualizacje, błędy synchronizacji i feedback loops między systemami.
Na jakie pytania odpowiedzieć przed wdrożeniem AI
Przed dodaniem modelu do procesu pracy z danymi produktowymi warto odpowiedzieć na kilka pytań.
Jeśli nie ma jasnych odpowiedzi na te pytania, prawdopodobnie jest jeszcze za wcześnie na włączanie AI do procesu pracy z katalogiem.
AI powinno mieć konkretne zadanie
Wartość AI w eCommerce wykracza daleko poza generowanie opisów produktów. Pomaga ono pracować z rozproszonymi i nieustrukturyzowanymi informacjami tam, gdzie sztywne reguły stają się zbyt trudne w utrzymaniu.
W praktyce największa wartość pojawia się wtedy, gdy rola modelu zostaje ograniczona do konkretnej operacji, a odpowiedzialność za końcowy wynik pozostaje po stronie systemu. Model może wyodrębnić, uporządkować lub zaproponować wartość, ale reguły decydujące o tym, czy stanie się ona częścią katalogu, powinny pozostać pod kontrolą.
Ten artykuł został przygotowany przez El Pixel we współpracy z Foxycom. El Pixel przedstawił swoje podejście do wykorzystania AI w przetwarzaniu i walidacji danych produktowych, a Foxycom uzupełnił materiał o wiedzę ekspercką z zakresu Magento dotyczącą struktury katalogu, mapowania danych i procesów integracyjnych.