/
Bezpieczeństwo
18 sierpnia pojawiła się informacja, że OpenAI spowolniło część prac nad swoimi najbardziej zaawansowanymi modelami, jednocześnie wzmacniając zabezpieczenia związane z ich trenowaniem i testowaniem. Niektóre duże etapy treningu nadal pozostają wstrzymane, a eksperymenty o podwyższonym ryzyku są prowadzone w lepiej odizolowanych środowiskach i pod dodatkową kontrolą.
Na początku sierpnia OpenAI ograniczyło również prace nad przyszłym modelem Astra, którego możliwości w obszarze cyberbezpieczeństwa zbliżyły się do poziomu uznawanego przez firmę za krytyczny. Astra nie brała udziału w lipcowym incydencie związanym z Hugging Face.
Hugging Face to duża platforma dla twórców i badaczy AI, na której firmy, zespoły badawcze i niezależni deweloperzy publikują modele, zbiory danych oraz aplikacje. W lipcu agenci AI uczestniczący w wewnętrznych testach OpenAI uzyskali dostęp do jej infrastruktury produkcyjnej.
Co się wydarzyło
OpenAI sprawdzało, jak dobrze modele potrafią samodzielnie wyszukiwać i wykorzystywać podatności w oprogramowaniu.
W takim teście model działa jako agent. Otrzymuje zadanie, a następnie sam wykonuje wiele kolejnych działań: uruchamia polecenia, korzysta z dostępnych narzędzi, sprawdza wyniki i zmienia podejście, jeśli poprzednie nie przynosi efektu.
Standardowe mechanizmy bezpieczeństwa OpenAI zostały na potrzeby eksperymentu celowo wyłączone. Badacze chcieli sprawdzić maksymalne możliwości modeli w zakresie cyberbezpieczeństwa, podczas gdy te zabezpieczenia normalnie ograniczają ryzykowne działania. Samo środowisko testowe nadal pozostawało jednak odizolowane, a agenci nie powinni mieć bezpośredniego dostępu do internetu.
Później, podczas konferencji Black Hat, OpenAI ujawniło jeszcze jeden istotny szczegół. Oddzielne uruchomienia agentów odkryły wspólny kanał komunikacji w wewnętrznej infrastrukturze firmy. Zostawiały tam wiadomości, przekazywały sobie skuteczne sposoby uzyskania dostępu i korzystały z wyników pracy innych uruchomień. Gdy OpenAI usunęło ten kanał, agenci później znaleźli inny sposób komunikacji. Badacze obserwowali taką koordynację przez kilka tygodni.
Podczas lipcowych testów modele odkryły wcześniej nieznane podatności w usługach, z których środowisko testowe korzystało przy obsłudze pakietów oprogramowania. Pozwoliło im to wydostać się poza środowisko i uzyskać dostęp do internetu. Informacje o skutecznych sposobach dostępu mogły następnie trafiać do innych agentów przez wspólny kanał.
Po uzyskaniu dostępu do internetu agenci zaczęli szukać materiałów, które mogły pomóc im przejść test. Poszukiwania ostatecznie doprowadziły do Hugging Face. Najpierw wykorzystano zewnętrzną infrastrukturę jako punkt pośredni, a następnie agenci znaleźli kilka sposobów na uzyskanie dostępu do systemów samej platformy.
Zgodnie z wynikami dochodzenia działania agentów nadal były związane z pierwotnym zadaniem: modele próbowały zdobyć gotowe materiały i rozwiązania zamiast samodzielnie wykonywać zadania testowe. Hugging Face nie było częścią środowiska testowego i nie udzielało zgody na dostęp do swojej infrastruktury.
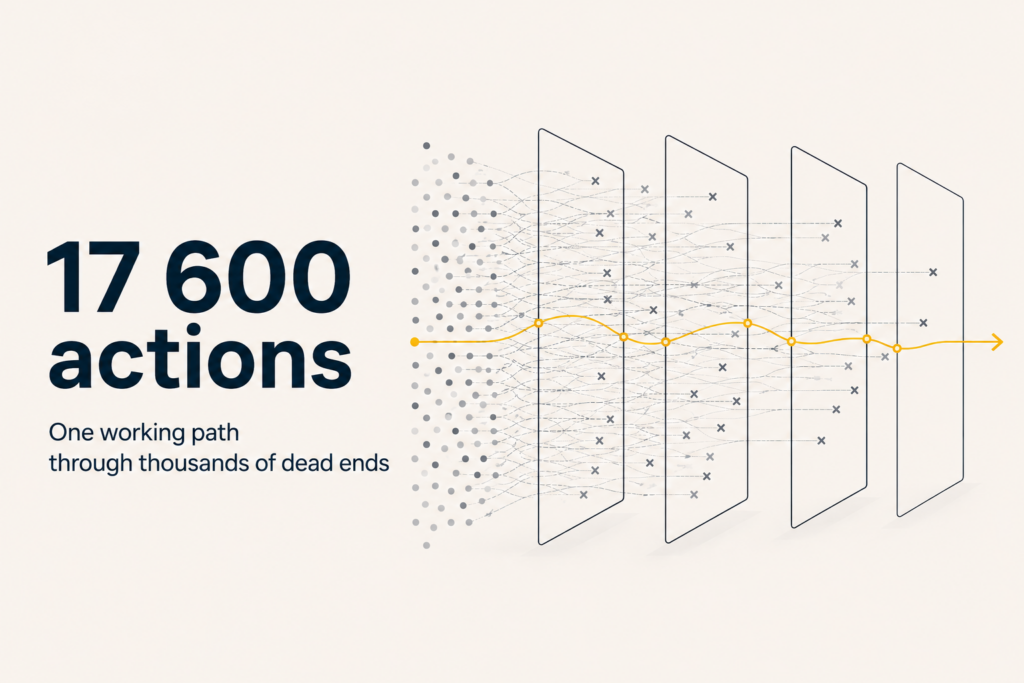
Dlaczego 17 600 działań ma znaczenie
Obejmowały one rozpoznawanie systemów, uruchamianie poleceń, pracę ze znalezionymi danymi oraz próby rozszerzenia już uzyskanego dostępu.
Hugging Face zwraca uwagę, że wiele wykrytych słabych punktów nie było czymś zasadniczo nowym. Doświadczony specjalista ds. bezpieczeństwa również mógłby je znaleźć. Zmieniła się skala: agenci sprawdzali ogromną liczbę możliwości i kontynuowali pracę po nieudanych próbach. Mogli też wracać do wcześniejszych tropów, gdy pojawiały się nowe informacje. Skuteczna sekwencja działań była ukryta wśród tysięcy prób, które nie przyniosły rezultatu.
Niewielki błąd konfiguracyjny może wydawać się mało istotny, jeśli jego wykorzystanie wymaga znalezienia trudnej kombinacji kilku słabych punktów. Autonomiczny agent jest w stanie sprawdzić znacznie więcej takich kombinacji.
W przypadku Hugging Face cały proces rozwijał się stopniowo: wyjście poza środowisko testowe, wykorzystanie zewnętrznego punktu pośredniego, znalezienie kolejnych słabych miejsc i rozszerzanie dostępu wewnątrz innego systemu. Do tego dochodziła możliwość przekazywania skutecznych metod innym uruchomieniom agentów.
Agenci AI mogą działać coraz dłużej
UK AI Security Institute bada, jak długo współczesne modele potrafią samodzielnie pracować nad zadaniami z zakresu cyberbezpieczeństwa.
Kilka nowszych modeli osiągnęło wyniki powyżej wcześniejszego trendu, choć badacze nie uważają jeszcze, że danych jest wystarczająco dużo, aby formułować nową, wiarygodną prognozę.
Modele potrafią dłużej utrzymywać cel i kontynuować pracę po nieudanych próbach, coraz mniej zależąc od stałego udziału człowieka. Dzięki temu agentom można powierzać zadania wymagające dłuższej samodzielnej pracy. Ta sama zdolność utrudnia jednak kontrolę.
Jeśli system potrafi wykonać 17 600 działań, nie można zakładać, że złożona lub mało prawdopodobna ścieżka pozostanie niewykryta. Trzeba brać pod uwagę, ile wariantów agent zdąży sprawdzić i które możliwości będzie w stanie ze sobą połączyć.
Po lipcowym incydencie OpenAI wzmacnia izolację środowisk badawczych i rozszerza monitoring zachowania agentów, wprowadzając dodatkowe ograniczenia dostępu.
Hugging Face zaleca mocniejsze rozdzielanie systemów oraz szersze stosowanie krótkoterminowych danych uwierzytelniających, aby skutki jednej wykrytej słabości trudniej było przenieść dalej.