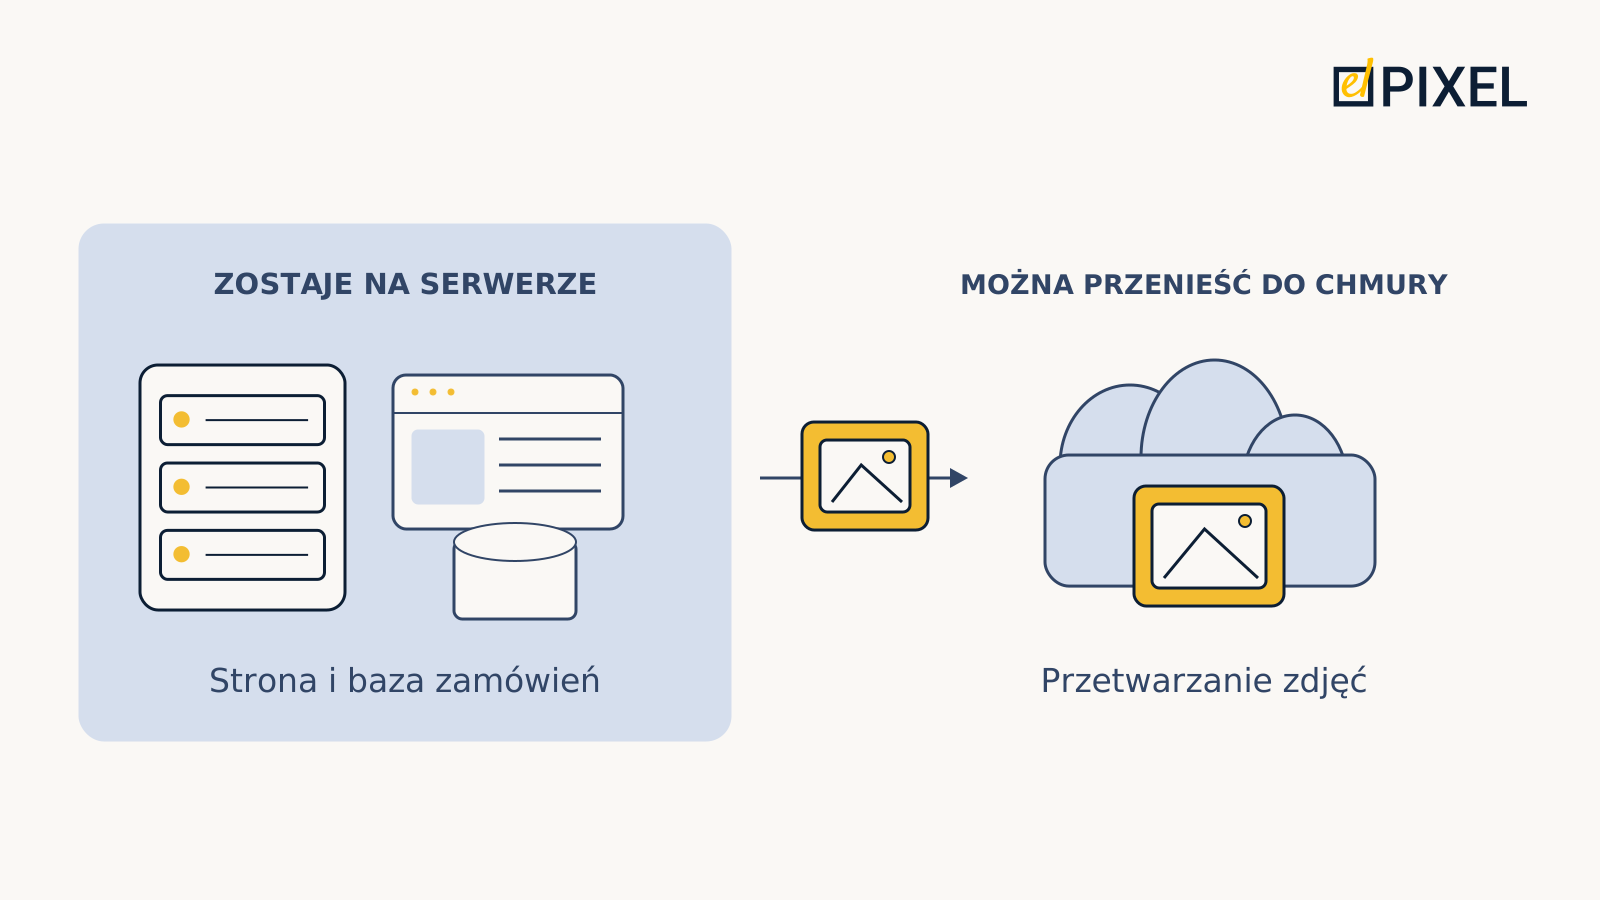
Załóżmy, że sklep internetowy przygotowuje promocję. Na jednym serwerze działają strona, baza zamówień i obróbka zdjęć produktów. Zespół prosi o większą moc, aby klienci mogli składać zamówienia bez opóźnień. Osoba zarządzająca firmą musi zdecydować, czy warto stale płacić za zapas zasobów potrzebny tylko podczas krótkiego szczytu obciążenia.
Chmura pozwala dostosowywać zasoby do zadania i przekazywać dostawcy część prac związanych z ich utrzymaniem. Nie oznacza to jednak, że trzeba przenieść cały sklep. Jeśli stronę spowalnia obróbka zdjęć, warto najpierw sprawdzić możliwość wydzielenia właśnie tego zadania. Jeżeli przyczyną jest wolne zapytanie do bazy, zmiana miejsca utrzymywania systemu może w ogóle nie być potrzebna. Wybór warto więc rozpatrywać dla poszczególnych zadań produktu: które skorzystają z możliwości chmury, a które już dobrze działają na serwerze dedykowanym.
Co zmienia przejście do chmury
Serwer dedykowany, czyli dedicated server, to fizyczna maszyna używana przez jednego klienta. Ma określoną konfigurację procesora, pamięci i dysków. Zespół umieszcza na niej aplikację, a podział obowiązków dotyczących aktualizacji i usuwania awarii wynika z umowy o utrzymanie.
W chmurze aplikacja także korzysta ze sprzętu fizycznego, lecz zespół zwykle pracuje z serwerami wirtualnymi oraz osobnymi usługami przechowywania danych, sieci lub baz danych. Daje to więcej sposobów zarządzania infrastrukturą: zasoby można przydzielać poszczególnym częściom produktu, dodawać w razie potrzeby i zwalniać po zakończeniu pracy. Możliwości i ograniczenia zależą od platformy.
Dla osoby zarządzającej istotne są tu dwa różne efekty. Pierwszy to elastyczność, na przykład dodatkowa moc tylko na czas promocji. Drugi dotyczy utrzymania: zespół chce przekazać dostawcy obsługę konkretnego komponentu. Aby uzyskać ten drugi efekt, nie wystarczy przenieść aplikacji na zwykłą maszynę wirtualną w chmurze. Aktualizacja zainstalowanego na niej oprogramowania nie staje się automatycznie obowiązkiem dostawcy.
Część tych prac można przekazać przez usługę zarządzaną, na przykład usługę bazy danych. Za dane, uprawnienia użytkowników i działanie aplikacji nadal odpowiada zespół produktu. Przed wyborem usługi trzeba więc ustalić, jakie dokładnie prace przejmuje dostawca, a co pozostaje po stronie klienta. Szczegóły takiego podziału pokazuje model współodpowiedzialności AWS, po angielsku.
Które zadania łatwiej oddzielić od głównego serwera
Wróćmy do obróbki zdjęć. Klient nie musi czekać na jej zakończenie przy każdym otwarciu strony: nowe obrazy można przygotować po przesłaniu, a następnie korzystać z gotowych plików. Jeśli produkt dopuszcza taki przebieg, aplikacja umieszcza zadania w kolejce, skąd pobierają je osobne procesy robocze. Gdy zdjęć jest dużo, procesów można uruchomić więcej, a po opróżnieniu kolejki zwolnić nadmiarowe zasoby.

Taki komponent można sprawdzić bez przełączania całego sklepu. Zespół musi uwzględnić awarie i ponowienia: kolejne uruchomienie zadania nie może tworzyć błędnych duplikatów ani powodować utraty pracy. Podobnie można rozpatrywać generowanie raportów i inne zadania wykonywane w tle, o ile ich wymagania dopuszczają oczekiwanie.
W przypadku samej strony sytuacja jest bardziej złożona. Podczas promocji dodatkowe instancje aplikacji mogą równolegle obsługiwać żądania klientów, a mechanizm równoważenia obciążenia rozdziela ruch między nimi. Instancje muszą jednak pracować ze spójnymi danymi. Koszyk zapisany wyłącznie w pamięci jednej maszyny będzie niedostępny dla drugiej. Zwiększenie liczby serwerów aplikacji nie usuwa też ograniczenia wspólnej bazy danych.
Elastyczność chmury przynosi zatem korzyść wtedy, gdy produkt jest przygotowany do takiego podziału pracy. Zespół najpierw sprawdza, które części mogą działać równolegle i co ogranicza łączną wydajność, a następnie konfiguruje dodawanie i wyłączanie zasobów. Sam mechanizm szerzej opisuje przewodnik AWS dotyczący skalowania, po angielsku. Dokument wyjaśnia możliwości platformy, lecz nie dowodzi gotowości konkretnego sklepu do ich wykorzystania.
W części zadań ważniejszy od skalowania jest ich tymczasowy charakter. Środowisko testowe można utworzyć na czas sprawdzania zmian i usunąć po zakończeniu. Potencjalne oszczędności zależą od organizacji pracy: zbędne zasoby trzeba rzeczywiście wyłączać, a potrzebne dane zachowywać oddzielnie. Zarządzaną bazę danych rozpatruje się natomiast przede wszystkim po to, aby ograniczyć konkretne obowiązki eksploatacyjne. Jej zgodność z aplikacją, ustawienia i odtwarzanie wymagają osobnej oceny, ponieważ od bazy może zależeć niemal każde działanie użytkownika.
Kiedy serwer dedykowany pozostaje rozsądnym wyborem
Opisane scenariusze chmurowe mają wspólny powód zmiany: zasoby lub obowiązki można dostosowywać osobno dla różnych części produktu. Jeśli takiej potrzeby nie ma, migracja wymaga innego uzasadnienia. Przy stale wysokim obciążeniu wynajem fizycznej maszyny może kosztować mniej niż porównywalne zasoby chmurowe, zwłaszcza gdy jej moc jest regularnie wykorzystywana. Potwierdzi to dopiero obliczenie oparte na rzeczywistym obciążeniu.
W porównaniu należy uwzględnić także wymagania sprzętowe aplikacji. Znaczenie mogą mieć konkretna konfiguracja fizyczna i bezpośrednia kontrola nad sprzętem. Sama potrzeba wysokiej wydajności nie oznacza jednak, że jedyną opcją jest serwer dedykowany: oferty chmurowe też się różnią i obejmują maszyny wirtualne z wydzielonymi zasobami procesora. Trzeba odróżniać je od wynajmu całej fizycznej maszyny i porównywać warunki konkretnych ofert.
Nawet odpowiednia usługa chmurowa może nie uzasadniać zmian w działającym produkcie. Jeżeli obciążenie jest przewidywalne, utrzymanie zorganizowane, a obecny serwer spełnia wymagania, koszt migracji i przebudowy aplikacji może przekroczyć oczekiwane korzyści. Ma to szczególne znaczenie w starszym produkcie, którego komponenty są silnie powiązane: wydzielenie jednego zadania może wymagać zmian w kilku miejscach.
Jeśli ograniczenie można usunąć przez dostrojenie bazy lub poprawkę aplikacji, warto najpierw sprawdzić tę drogę. Aby wybrać pierwszy krok, porównaj swoją sytuację z warunkami na schemacie.

Jak porównać koszty bez pozornych oszczędności
Wybór między pozostawieniem serwera, przeniesieniem jednego komponentu a pełną migracją wymaga kosztorysów dla tego samego obciążenia i jednakowych wymagań dostępności. W przeciwnym razie koszt działającego produktu można zestawić z ceną jednej maszyny w chmurze, pomijając niezbędne komponenty i utrzymanie.
Poproś zespół o uwzględnienie mocy obliczeniowej, dysków, przechowywania kopii zapasowych, transferu danych, elementów sieciowych, monitoringu i czasu specjalistów. Osobno należy pokazać jednorazowy koszt zmian w aplikacji i migracji, w tym okres równoległego działania obu środowisk. Dla wariantu chmurowego warto oszacować zwykłe obciążenie, przewidywany szczyt i wzrost ilości danych. Pokaże to, które założenie najmocniej wpływa na wynik.
Częściowa migracja wymaga takiego samego rachunku. Jeśli aplikacja pozostanie na serwerze dedykowanym, a baza trafi do chmury, między nimi powstanie zależność od łącza. Opóźnienia i niedostępność połączenia wpłyną na działania użytkowników, a transfer danych może stać się osobną pozycją kosztową. Infrastrukturę warto więc dzielić po sprawdzeniu zależności między komponentami, a nie tylko dlatego, że technicznie da się je umieścić oddzielnie.
Ta sama zasada dotyczy odporności na awarie. Jedna maszyna z aplikacją pozostaje jedną maszyną niezależnie od miejsca wynajmu. Jeśli firma musi kontynuować pracę po jej awarii, oba kosztorysy powinny uwzględniać potrzebne komponenty zapasowe i sposób odtworzenia systemu. Samo posiadanie kopii danych nie pokazuje jeszcze, kiedy klienci znów będą mogli składać zamówienia.
Jak sprawdzić decyzję przed pełną migracją
Kosztorys pokazuje przewidywane wydatki, a pilotaż pozwala sprawdzić założenia na wybranym komponencie. Przed jego rozpoczęciem zespół powinien zmierzyć stan wyjściowy: kiedy rośnie obciążenie, jaki zasób ogranicza pracę i co wtedy widzi użytkownik. Te dane pozwalają odróżnić brak zasobów od błędu aplikacji, a później ocenić zmianę.
Kryteria odbioru należy określić z wyprzedzeniem. Dla pracy w tle mogą to być czas uzyskania wyniku, brak utraconych zadań i koszt wykonania. W przypadku strony sprawdza się czas kluczowej czynności przy uzgodnionym obciążeniu oraz odtworzenie działania po awarii. Wartości graniczne powinny wynikać z wymagań biznesowych, a nie z możliwości upatrzonej platformy.
Wraz z kryteriami potrzebny jest plan powrotu. Jeżeli dane w nowym systemie już się zmieniły, samo przełączenie adresu z powrotem nie wystarczy: zmiany trzeba zachować bez zakłócenia działania produktu. Dlatego przed migracją należy wyznaczyć osobę odpowiedzialną za decyzję o powrocie i uzgodnić sposób sprawdzenia integralności danych.
Po pilotażu osoba zarządzająca powinna mieć zmierzone wyniki, pełny kosztorys i jasny podział obowiązków. Na tej podstawie może zdecydować o rozszerzeniu migracji, zmianie podejścia albo pozostawieniu serwera dedykowanego. Jeżeli ocena wymaga wydzielenia części aplikacji, zmiany obsługi danych lub przemyślenia architektury, zadanie można omówić z EL Pixel w ramach rozwoju produktu.
W pierwszej wiadomości wystarczy opisać produkt, obecny sposób utrzymywania systemu, zaobserwowane ograniczenie i najbliższą przewidywaną zmianę obciążenia. Pozwoli to rozpocząć rozmowę o zadaniu i wymaganiach bez gotowej specyfikacji technicznej.